特征缩放
特征缩放是一种数据预处理技术,通过对某个特征的数值乘以或除以一个常数来改变其取值范围。视频中展示了将连续特征除以2(),使其直方图分布向零收缩。
Normalized Nerd · YouTube · 5:48
本视频片段介绍了数据预处理中特征缩放与归一化的概念。通过一个以直方图表示的连续特征,主讲人演示了将数据除以一个常数(缩放)如何压缩其分布;接着展示了先减去一个常数再除以一个常数(缩放与平移)如何移动并压缩该分布;最后,该片段将最小-最大归一化定义为缩放与平移的一种特例,其中所用常数由数据集的最小值和最大值导出,从而有效标准化数据的取值范围。 本视频讲解两种常见的特征缩放技术:最小-最大归一化与标准化。视频给出了它们的公式,并通过可视化方式演示了二者如何变换数据分布。视频特别澄清了一个常见误解:标准化并不会将任意分布变为正态分布;它仅是一种线性变换。最后,视频介绍了特征缩放在优化算法(如梯度下降)中实现更快收敛的重要性,并展示了相关的参数更新规则与损失函数。 本视频解释了特征缩放在机器学习中至关重要的原因,聚焦于两点:第一,通过等高线图可视化展示,未缩放且量级差异极大的特征会导致梯度下降中步长不均衡,从而引发低效振荡与收敛变慢;第二,在 KNN 等基于距离的算法中,量级更大的特征会在距离计算中占据主导地位,掩盖其他特征的真实重要性。一段散点图动画展示了归一化如何平衡各特征的贡献,从而实现更公平的距离计算与更优的算法性能。 本片段时长为24秒,主体为结尾部分。前4秒展示一张标题为“为何特征缩放很重要?”的幻灯片,列出两条理由:“收敛更快”和“恰当计算距离”,并附有一张散点图,将两个高亮显示的点之间的距离分解为垂直分量和水平分量。4秒后,视频切换至标有“标准化NERD”的结束卡片,含订阅提示与社交链接,仅配器乐音乐。
在学习检查器中查看要点和时刻,或切换阅读标签查看完整笔记。
依据视频画面与讲解整理,并非逐字语音转写。
视频开头,创作者在休整后欢迎观众回归,并引出本期主题:特征缩放与归一化,旨在澄清常见误解。
为讲解特征缩放,首先引入一个记作的原始连续数值型特征;并用青绿色直方图可视化该特征值的初始分布。
演示的第一个变换是基础特征缩放。通过将的每个值除以2,应用公式。直观上,会出现一个新的紫色直方图,表明分布已被压缩或‘收缩’向原点。
接下来,视频介绍了缩放与平移。这包括先减去一个常数,再除以另一个常数。示例使用的公式是。显示了一个红色直方图,说明分布沿x轴向左平移,同时被收缩。
最后,引入归一化的概念,作为缩放与平移的一种特定且有明确目的的应用。最小-最大归一化由公式定义,其中和分别是该特征的最小值和最大值。出现一个粉红色直方图,紧密聚集在零附近,展示了该方法如何标准化数据的取值范围。
视频首先介绍最小-最大归一化。公式被显示出来,动画则展示一个粉色直方图沿x轴被缩放至介于0与1之间。该变换确保所有数据点均落在这一特定区间内。
接着介绍标准化的概念,公式为。动画随之更新,展示直方图发生平移与缩放,使其均值位于0,且其离散程度体现为标准差1。讲解者强调,这是一种线性变换。
视频指出一个常见误解:认为标准化会强制数据变为正态(钟形)分布。为证伪该观点,视频展示了一个高度右偏的蓝色直方图;对其实施标准化后,所得橙色直方图仍保持原有偏态形状,表明标准化仅调整均值与标准差,并不改变数据分布的基本形态。
随后,视频转向特征缩放的实际意义,即在机器学习模型中实现更快收敛。视频引入梯度下降更新规则与最小二乘损失函数,为解释未缩放特征如何对优化过程产生负面影响做好铺垫。
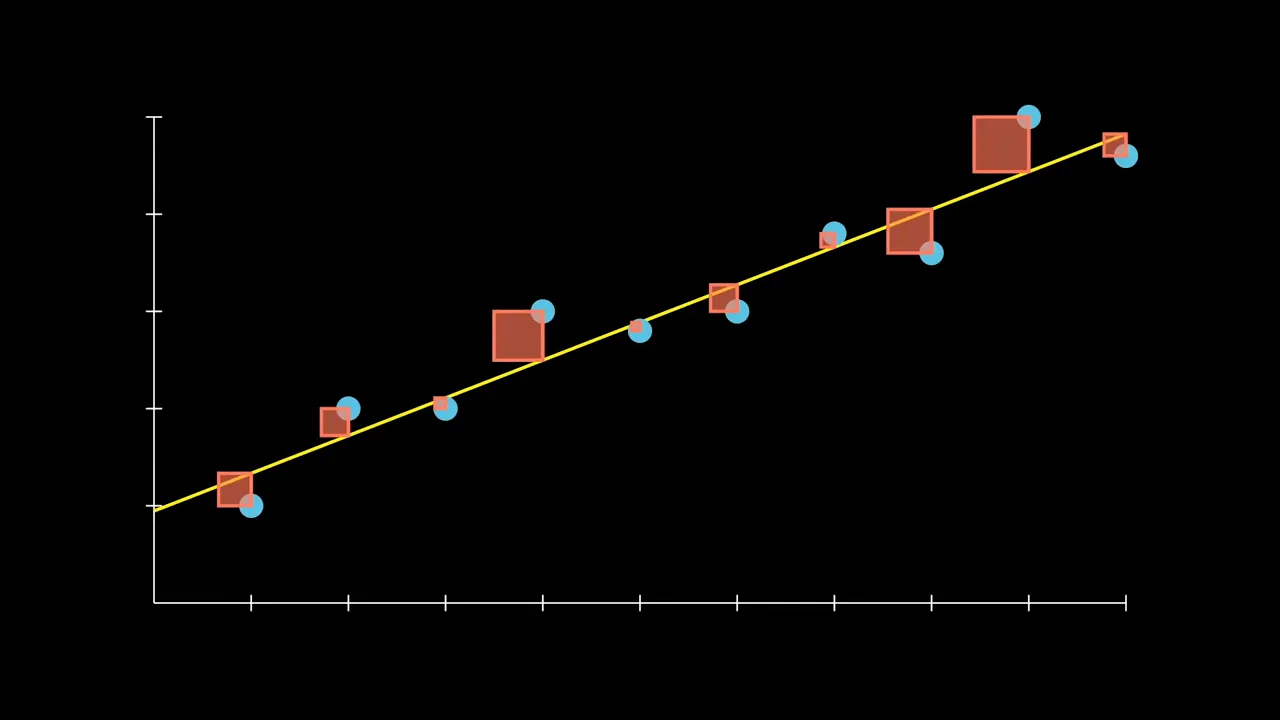
视频首先探讨特征缩放的必要性,给出了两个参数 和 的梯度下降更新规则,以及均方误差代价函数 。讲解者设定一个场景:特征 的取值范围为 0 到 1,而特征 的取值范围为 100 到 1000。
分析更新公式时,讲解者指出,由于很小,乘以误差的梯度项也会很小,从而导致的步长很小;相反,的幅值很大,使得的步长很大。这种步长差异会导致优化路径低效且来回振荡,视觉上表现为拉长的蓝色等高线内一条红色锯齿状折线,最终延缓收敛过程。
转向特征缩放的第二个原因,重点转为基于内存的算法(如KNN和K均值)中的距离计算。引入一幅散点图,其中横轴特征的取值范围远大于纵轴特征。
讲解者强调,在这个未经缩放的空间中计算两点间的欧氏距离时,仅因横轴方向数值尺度更大(而非其预测重要性更高),横轴方向的差值便主导了纵轴方向的差值。连接两个红色点的黄色线段几乎完全呈水平走向,直观体现了这种主导效应。
为纠正这一失衡,对两个坐标轴同时实施归一化处理。动画显示数据点在横轴方向被压缩。此时重新计算距离,所得线段的横、纵分量大致贡献相等,从而确保算法不会受制于各特征任意的数值尺度。
本节最后总结道:特征缩放既能防止优化过程低效,又能保障距离计算的公平性,至此完成全部解释。
该片段以一张标题为“为何特征缩放很重要?”的总结幻灯片开场。其上列出两个要点:“收敛更快”与“恰当计算距离”。下方散点图中,两个红色点由一条黄色线段连接;一条蓝色垂直线段与一条紫色水平线段共同构成一个直角三角形。这一视觉呈现表明:点之间的分离可通过各坐标方向上的差值来理解,因此特征尺度不一致会扭曲基于距离的推理。
大约在4秒处,数学内容幻灯片被替换为频道结束卡片,显示“归一化NERD”字样,以及“观看下一个……”、社交平台账号、订阅提示和“点赞 | 评论 | 分享”。口头结束语刚刚结束,之后整段视频仅保留纯音乐。本结尾部分未引入任何新的数学内容。
特征缩放是一种数据预处理技术,通过对某个特征的数值乘以或除以一个常数来改变其取值范围。视频中展示了将连续特征除以2(),使其直方图分布向零收缩。
缩放与平移在基础特征缩放的基础上进一步扩展:先从特征值中减去一个常数,再除以另一个常数。示例展示了该变换如何既沿x轴平移数据分布,又改变其离散程度。
最小-最大归一化是一种特定类型的缩放与平移,用于将数据标准化到一个固定区间,通常是[0, 1]。其计算方式为:先减去该特征的最小值(),再除以该特征的取值范围()。视频中显示,该方法使直方图紧密收缩在零附近。
将数据缩放到固定区间,通常为[0, 1]。公式:。其做法是减去最小值,再除以极差。
将数据居中处理,使其均值为0、标准差为1。公式:。该过程先减去均值,再除以标准差。
标准化并不会将分布的形状变为正态分布。它仅是一种线性变换,只对数据进行平移和缩放。
当特征的量纲差异极大时,特征缩放对于梯度下降等优化算法实现更快收敛至关重要。
展示参数和为最小化代价函数而进行迭代更新的公式。更新幅度取决于学习率以及梯度,该梯度中包含特征值和。
线性回归的目标函数,用于计算预测值与真实目标值之间平均平方差。梯度下降旨在寻找使该函数最小化的参数。
不同取值范围的未缩放特征会导致梯度幅值不均衡,进而造成某些参数更新步长过小、另一些参数步长过大,最终形成振荡式优化路径并减慢收敛速度,这在等高线图动画中得到直观呈现。
在依赖距离度量的算法(例如KNN)中,数值范围更大的特征会在距离计算中占据主导地位。这种偏差与特征的实际重要性无关,可能损害模型性能。
应用归一化(或标准化)可将各特征缩放到可比的数值范围内。这确保每个特征对距离计算的贡献大致相等,从而消除原始量纲所引入的人为偏差,如散点图动画所示。
视频指出特征缩放有两个实际动因:加快收敛速度,以及实现恰当的距离计算。配图的散点图通过标出两个点,并将其间距分解为垂直与水平两个分量(由一条对角线段连接),直观强化了‘距离’这一概念。本片段未给出公式或证明,仅作为简明的概念性总结。
一条黄色线段连接两个红色点,同时一条蓝色垂直线段与一条紫色水平线段构成直角三角形,该黄色线段即为其斜边。这一视觉呈现表明:点与点之间的距离源于各坐标方向上的差值。在特征缩放的语境下,其含义是:若各坐标轴尺度不同,则这些分量差值将无法等量贡献于距离计算——除非先对特征进行缩放。
按知识点查看条件、步骤和证据。补充解释与视频直接内容分别标明。
主讲人说:“假设 x 是原始数据集中的一个连续型特征。”
屏幕文字显示:“原始特征:x”
x
预处理前的连续型原始特征。
连续型数值。
屏幕文字显示:“缩放:x' = ”
主讲人说:“现在我将 x 的每个值都除以 2。”
x'
将原始特征除以 2后得到的缩放版本。
连续型数值。
屏幕文字显示:“缩放与平移:x' = (x - 7) / 2”
主讲人说:“这里我先减去 7,再除以 2。”
x'
减去 7并除以 2后得到的变换特征。
连续型数值。
屏幕文字显示:“最小-最大归一化:x' = (x - x_min) / (x_max - x_min)”。
说话人提到“x 的最小值”。
数据集中特征 x 的最小值。
来自该特征分布的一个标量值。
屏幕文字显示:“最小-最大归一化:x' = (x - x_min) / (x_max - x_min)”。
说话人提到“x 的最大……值”。
数据集中特征 x 的最大值。
来自该特征分布的一个标量值。
屏幕文字显示:“最小-最大归一化:x' = (x - x_min) / (x_max - x_min)”。
x'
原始特征经最小-最大归一化后的版本。
连续型数值。
出现在文本“原始特征:x”以及最小-最大归一化和标准化的公式中。
在解释变换过程时被称为“x”。
x
变换前的原始特征值。
实数
出现在最小-最大归一化和标准化方程的左侧。
x'
应用归一化或标准化后得到的变换后特征值。
实数
出现在最小-最大归一化公式的分子和分母中。
x_{min}
数据集中原始特征x的最小值。
实数
出现在最小-最大归一化公式的分母中。
x_{max}
数据集中原始特征x的最大值。
实数
出现在标准化公式分子中。
称为“均值”。
数据集中原始特征 x 的均值(平均值)。
实数
出现在标准化公式分母中。
称为“标准差”。
数据集中原始特征 x 的标准差。
正实数
说话人说:“嗯,这是一个特征缩放的例子,我们实际上将该特征缩小为原来的一半。”
屏幕文字显示“缩放:x' = ”。
一个紫色直方图出现在青绿色直方图左侧,显示分布被压缩向零点。
特征缩放是指将某个特征的取值乘以或除以一个常数,从而改变其取值范围。在视频中,将 x 的每个取值都除以 2,会使直方图收缩。
适用于连续型数值特征。
说话人说:“我们也可以先减去一个数,再除以另一个数。”
屏幕文字显示“缩放与平移:x' = (x - 7) / 2”。
一个红色直方图出现在更左侧,显示分布发生了平移和收缩。
缩放与平移是指先从特征取值中减去一个常数,再除以另一个常数。这会同时改变数据分布的位置和离散程度。
适用于连续型数值特征。
说话人说:“如果我们用 x 的最小值来减去 x,再除以 x 的最大值与最小值之差,就称之为最小-最大归一化。”
屏幕文字显示:“最小-最大归一化:x' = (x - x_min) / (x_max - x_min)”。
一个粉红色直方图在x轴上紧密聚集于零附近。
最小-最大归一化是一种特定的缩放与平移方法,其中减去的值是该特征的最小值,除数是该特征的极差(即最大值减最小值)。该方法将数据缩放到一个标准区间,通常为0到1。
适用于连续型数值特征。
需要事先知道该特征的最小值和最大值。
最小-最大归一化:x' = (x - x_{min}) / (x_{max} - x_{min})
最小-最大归一化将数据映射到零到一的范围内。
最小-最大归一化是一种线性变换,它将原始特征值缩放到一个固定范围,通常是0到1。该方法从每个数据点中减去该特征的最小值,再除以该特征的极差(最大值减最小值)。
该特征必须具有明确定义的最小值和最大值。
最大值与最小值不能相等(以避免除零错误)。
标准化:x' = () /
此处我们用 x 减去其均值,再除以其标准差。
标准化是一种线性变换,其作用仅仅是使均值为零、标准差为一。
标准化(又称 Z 分数归一化)是一种线性变换,它将数据以零为中心进行平移,并缩放至标准差为一。该方法从每个数据点中减去该特征的均值,再除以其标准差。
该特征必须具有明确定义的均值和标准差。
标准差不能为零(以避免除零错误)。
θᵢ 更新为 θᵢ 减去 α 乘以 对 θᵢ 的偏导数
采用经典的梯度下降算法。
梯度下降是一种优化算法,通过沿代价函数关于各参数的梯度的反方向迭代更新模型参数,从而最小化代价函数。
代价函数 J 必须关于参数 θ 可微。
学习率 α 必须适当选取,以确保收敛。
除以 2m,再乘以求和符号,括号内为 的 2 次方
如果我们假设采用最小二乘代价函数……
最小二乘代价函数用于衡量预测值(基于模型参数与特征计算得出)与实际目标值之间的平均平方差,常用于线性回归。
用于回归问题,目标是预测一个连续值。
假设特征与目标变量之间存在线性关系。
视频展示了参数 theta_1 和 theta_2 的同步更新方程。
这些公式展示了参数 和 如何通过迭代更新来最小化代价函数:每次更新都减去学习率 与该参数对应的代价函数平均梯度的乘积。
用于线性回归优化。
视频展示了均方误差代价函数 J(theta_1, theta_2)。
该公式计算预测值()与实际目标值()在全部 个训练样本上的平均平方差。它作为梯度下降旨在最小化的目标函数。
假设采用具有两个特征的线性模型。
讲解者指出,量级差异极大的特征会导致一个参数的步长过小,而另一个参数的步长过大,从而引发振荡并延缓收敛。
等高线图呈现出狭长的山谷形状,以及一条朝向最小值点的之字形路径。
当特征具有显著不同的量纲时,其对应参数的梯度也会差异极大。这导致梯度下降的每一步不均衡,形成低效且振荡的收敛路径,并减慢收敛速度。
适用于梯度下降等迭代优化算法。
讲解者指出,基于记忆的算法依赖于距离计算,而未经缩放的特征会导致数值范围更大的特征在距离计算中占据主导地位。
散点图显示数据点在x轴方向上分布很广,在y轴方向上分布很窄;连接两点的线段几乎完全是水平的。
在依赖距离度量的算法(如K近邻或K均值)中,数值范围更大的特征会对总距离产生不成比例的影响。对特征进行归一化可确保每个特征对距离计算的贡献大致相等,从而避免尺度大小决定其重要性。
适用于基于距离的机器学习算法。
屏幕标题显示:“为什么特征缩放很重要?”,
屏幕上可见两个要点:“收敛更快”和“恰当计算距离”。
第二个要点旁配有一张散点图,图中有一条黄色直线,以及若干着色的直角三角形线段。
该片段提出了特征缩放重要的两个原因:它可使算法收敛得更快,也有助于恰当计算距离。所附示意图通过将坐标差表示为水平与垂直两个独立分量,并以一条对角线段连接它们,来强调“距离计算”这一要点。
内容以总结性幻灯片形式呈现,而非推导过程。
本片段中未出现任何公式或算法名称。
初学者中存在一个巨大误解:认为只要进行标准化,数据分布就会变成正态分布。这显然是错误的。
事实上,标准化是一种线性变换,它仅将均值变为零、标准差变为一。
展示了一个高度偏斜的分布;在应用标准化后,其形状依然偏斜,并未变成钟形曲线。
对数据集进行标准化不会改变其分布的整体形状;它仅将均值平移至零,并将标准差缩放为一。
该数据集具有明确定义的均值和标准差。
适用于任意数据集。
讲解者明确指出,步长差异可能导致不希望出现的振荡,并延缓收敛。
在等高线图中可视化振荡路径。
如果特征的取值范围差异很大,优化过程中梯度幅值的差异就可能引发不希望出现的振荡,并延缓收敛。
特征具有显著不同的量级。
使用了梯度下降等迭代优化算法。
针对所有此类特征集及优化过程。
讲解者指出,在计算距离时,由于水平方向的数值尺度更大,其分量会主导垂直方向的分量,但这并不一定意味着它更重要。
展示了一条近乎水平的线段,表示未缩放散点图中两点之间的距离。
在计算数据点之间的距离时,数值范围更大的特征将主导距离度量,无论其实际预测重要性如何。
特征未经过缩放或归一化处理。
距离使用标准度量(如欧氏距离)进行计算。
针对数据集中任意一对点。
我们为何要关注特征缩放与归一化?第一个原因是实现更快的收敛。
展示了梯度下降更新规则和最小二乘损失函数。
视频在完全解释未缩放特征如何影响梯度下降步骤之前就中断了。
特征缩放与归一化之所以重要,主要是为了在模型训练过程中实现更快的收敛。
音频中直接说明。
在梯度下降等算法中,参数根据损失函数的梯度进行更新。
公式显示在屏幕上,并在音频中提及。
对于包含两个特征的最小二乘损失函数,其梯度依赖于这两个特征的取值。
公式显示在屏幕上,并在音频中提及。
未缩放的特征可能导致某些参数的梯度很大,而另一些参数的梯度很小,从而造成收敛缓慢且效率低下。(注:视频暗示了这一点,但在明确得出该结论前就中断了。)
讲解者根据所展示的更新公式,推断小 和大 对 theta_1 与 theta_2 步长的影响。
更新公式显示 和 均乘以误差项。
参数 的变化量正比于特征值 。
从梯度下降更新规则的结构中可以看出。
由于的取值范围较小,因此的步长也会较小。
结合数学比例关系的语音讲解。
参数的变化量与特征值成正比。
从梯度下降更新规则的结构中可以看出。
由于的取值范围较大,因此的步长也会较大。
结合数学比例关系的语音讲解。
尺度差异较大的特征会导致梯度下降过程中对应参数的更新幅度不成比例。
说话人说:“现在我将把x的每个值都除以2。”
屏幕文字显示:“缩放:x' = ”。
紫色直方图相较于原始的青绿色直方图显得被压缩。
通过将一个连续型特征除以2来演示特征缩放。
一个具有给定直方图分布的连续型特征x。
展示将 x 除以2如何影响其分布。
将特征 x 的每个取值都除以2。
视频中给出的特征缩放定义。
该特征的分布被压缩,如紫色直方图向零点靠近所示。
紫色直方图与原始青色直方图的可视化对比。
说话人说:“这里我先减去7,再除以2。”
屏幕文字显示:“缩放与平移:x' = (x - 7) / 2”。
红色直方图相对于原始青色直方图向左平移并被压缩。
通过减去7并除以2来演示缩放与平移。
一个具有给定直方图分布的连续特征 x。
展示减去7并除以2如何影响其分布。
从特征 x 的每个取值中减去7,再将结果除以2。
视频中介绍的缩放与平移定义。
该特征的分布向左平移并收缩,如红色直方图所示。
红色直方图与原始青绿色直方图的直观对比。
说话人说:“若用 x 减去 x 的最小值,再除以 x 的最大值与最小值之差,则称之为最小-最大归一化。”
屏幕文字显示:“最小-最大归一化:x' = (x - x_min) / (x_max - x_min)”。
粉色直方图显示数据紧密聚集在零附近。
使用该特征的最小值和最大值来演示最小-最大归一化。
一个具有给定直方图分布的连续特征 x。
该特征的最小值 x_min 和最大值 x_max。
展示最小-最大归一化对该分布的影响。
从每个数据点中减去 x 的最小值,再除以极差(x_max - x_min)。
视频中给出的最小-最大归一化定义。
该分布被缩放到一个起始值接近零的狭窄区间,粉红色直方图直观地展示了这一效果。
粉红色直方图与原始青色直方图的可视化对比。
我们来看一个极度偏斜的分布。如果对这个分布进行标准化处理,你会发现其形状并不像正态分布,对吗?
屏幕上显示一个蓝色直方图,代表高度右偏的分布;随后显示一个橙色直方图,代表同一组数据经标准化后的结果,其仍保持右偏的形状。
演示标准化对高度偏斜分布的影响。
一个高度右偏的分布(用蓝色直方图表示)。
检验标准化是否能将该偏斜分布转化为正态分布。
从一个高度右偏的分布开始。
以蓝色直方图直观呈现。
对数据应用标准化公式。
该公式在视频前文已给出。
观察变换后所得的分布。
以橙色直方图直观呈现。
标准化后的分布仍高度右偏;它并未变成正态分布(即钟形分布)。
原始直方图与标准化直方图的视觉对比显示,二者形状完全相同,仅在x轴方向上发生了平移与缩放。
主讲人给出和的具体取值范围以说明该问题。
取值范围写在代价函数下方:;。
分析当两个特征具有不同取值范围时,特征缩放对梯度下降收敛性的影响。
特征的取值范围为。
特征的取值范围为。
定义了代价函数及梯度下降更新规则。
分析特征尺度差异对优化过程的影响。
应用的更新规则。
梯度下降的定义。
应用的更新规则。
梯度下降的定义。
由于乘以误差项,其数值较小时会导致的更新量较小。
代数观察与语音讲解。
由于乘以误差项,其数值较大时会导致的更新量较大。
代数观察与语音讲解。
步长差异导致优化路径低效振荡,延缓收敛。
在拉长的蓝色等高线图中,以红色锯齿状路径直观呈现。
主讲人引入一个示例:沿坐标轴分布的两个特征具有不同取值范围,从而影响距离计算。
散点图显示数据点分布不均;归一化动画将横轴的分布范围压缩。
演示未缩放特征如何影响基于内存的算法中的距离计算。
两个特征分别绘制在横轴与纵轴上。
横轴特征的取值范围远大于纵轴特征。
展示大尺度特征在距离计算中的主导作用,以及归一化的影响。
标准欧氏距离公式(由KNN/K均值聚类的上下文隐含)。
背景知识应用于该可视化场景。
由于尺度更大,横轴方向上的差异在数值上显著更大。
散点图的视觉观察与语音讲解。
在平方根下的求和中,垂直分量变得可以忽略。
上一步的数学推论。
将两个坐标轴按比例缩放,使它们具有可比的取值范围。
语音指令与视觉动画。
归一化后,两个坐标轴方向上的差异幅度相近。
归一化散点图的视觉观察。
若不进行归一化,距离计算将主要由量级更大的特征主导;归一化确保两个特征大致同等贡献。
黄色线段在归一化动画前后的视觉对比。
青色直方图代表原始特征 x;随着不同变换的引入,新的直方图依次出现:紫色表示缩放,红色表示缩放加平移,粉红色表示最小-最大归一化。
青色直方图(原始特征)
紫色直方图(已缩放)
红色直方图(已缩放并平移)
粉红色直方图(最小-最大归一化)
与青色直方图相比,紫色直方图向零方向压缩。
与青色直方图相比,红色直方图向左平移且发生压缩。
粉色直方图在零附近高度集中。
分布的整体形状保持相似,但其在x轴上的位置和尺度发生变化。
这些可视化图示展示了线性变换(缩放、平移和标准化)如何影响数据分布的取值范围和位置,而不会从根本上改变其底层形状。
先显示一个粉红色直方图,其下方出现文字:‘原始特征:x’、‘最小-最大归一化:x = …’、‘标准化:x = …’。随后直方图颜色变为橙色,且其在x轴上的位置与尺度发生变化,以此说明标准化的效果。之后,显示一个蓝色偏斜直方图,它继而转变为橙色偏斜直方图。
粉色直方图
橙色直方图
蓝色直方图
带数字刻度的横轴
文本形式的公式
直方图颜色从粉色变为橙色,再从蓝色变为橙色。
直方图的位置与宽度沿横轴发生变化,以反映所施加的变换。
标准化之后,分布的整体形状(例如偏态)保持不变。
动画直观地展示了最小-最大归一化与标准化如何对数据分布进行平移和缩放,同时不改变其基本形状。
文字‘为什么特征缩放很重要?’出现,随后显示‘- 收敛更快’;接着依次展示梯度下降与最小二乘代价函数的数学公式。
文字标题
数学方程
公式逐个出现在屏幕上。
背景始终保持深色。
视觉呈现介绍了特征缩放必要性的理论依据,并将其与梯度下降等优化算法联系起来。
出现一幅等高线图,显示拉长的椭圆形等高线,以及一条向中心移动的红色锯齿状路径。
蓝色椭圆形等高线
红色之字形箭头/路径
坐标轴标注为和
红色路径在等高线的窄维度方向上来回振荡,同时沿长维度方向缓慢前进。
等高线的形状保持不变。
路径的起点和终点保持固定。
说明因特征未缩放导致梯度幅值差异,从而引发低效收敛。
散点图中绿色点在水平方向上分布较宽,在垂直方向上分布较窄;一条黄色直线连接两个红色点,该直线几乎呈水平。
绿色数据点
红色高亮显示的点
黄色距离线
横轴与纵轴
黄色线段连接两点,显示出较大的水平分量和极小的垂直分量。
绿色圆点的位置在此阶段保持不变。
演示了取值范围更大的特征如何在欧氏距离计算中占据主导地位。
散点图发生动画变化,压缩了各点的水平分布范围;黄色线段重新绘制,其水平分量与垂直分量均具有显著贡献。
绿色数据点(已移动)
红色高亮显示的点(已移动)
黄色距离线段(已重绘)
水平轴与垂直轴
各点向 y 轴靠近,水平分布范围减小;黄色线段的角度发生变化,以反映水平与垂直分量的均衡贡献。
点之间的相对顺序可能得以保持,但绝对距离发生改变。
表明归一化使得两个特征对距离度量的贡献大致相等。
一张深色背景幻灯片上,显示一幅笛卡尔风格的散点图,许多青绿色点聚集在原点附近。
两个红色点被突出显示:一个位于左上方,另一个位于右下方,一条黄色直线段连接这两点。
一条蓝色垂直线段从上方红色点垂下,一条紫色水平线段从该垂直线段的下端点延伸至下方红色点,从而与黄色线段共同构成一个直角三角形,其中黄色线段为斜边。
坐标轴标签与数字刻度值无法辨认。
散点
两个高亮的红色点
黄色连接线段
蓝色垂直线段
紫色水平线段
坐标轴
前四秒画面保持静止,同时画外音的结束语继续播放。
黄色线段始终表示两个红色点之间的直接间距。
蓝色线段和紫色线段始终分别表示纵坐标差与横坐标差。
该图示说明:两点间的距离可被分解为各坐标方向上的差值。结合本页幻灯片标题,这支持了如下论断:当不同特征具有不同量纲时,特征缩放会影响此类距离是否能被正确计算。
约在4秒时,幻灯片切换为结束卡片,显示“观看下一个……”、两个空白视频占位符、频道名称“normalized NERD”、社交平台账号、订阅提示,以及“点赞 | 评论 | 分享”。
画外音致谢结束后,余下片段仅播放纯音乐。
结束卡片背景
两个视频占位框
频道标志文字
社交媒体图标及账号名称
订阅箭头与圆圈
点赞 | 评论 | 分享 文字
数学幻灯片消失,并被宣传性片尾画面所取代。
语音停止,仅器乐音乐继续播放。
过渡之后不再出现新的数学内容。
该时段不包含额外的数学内容;其作用是作为视频结尾。
初学者中存在一个巨大误解:认为只要进行标准化,数据分布就会变成正态分布。这显然不正确。
许多初学者认为,对任意数据集应用标准化都会将其分布转化为正态(高斯)分布。
标准化是一种线性变换,它仅将均值调整为零、标准差调整为一;它不会改变分布本身的基本形状。若要改变形状,则需采用对数或平方根等非线性变换。
主讲人明确指出:“但水平方向的特征并不一定更重要,这只是因为其数值范围更大而已。”
误以为在距离计算中占主导地位的特征,对预测任务本身也必然更重要。
在距离计算中占主导地位,往往只是该特征数值范围较大所导致的人为现象,而非其真实预测能力或相关性的体现。
主讲人从解释简单缩放过渡到说:“我们也可以先减去一个数,再除以另一个数。”
缩放与平移通过在除法之前增加一个减法步骤,推广了基础特征缩放。
主讲人说:“但如果为它们选择某些特定值,我们就实现了标准化。”
最小-最大标准化是缩放与平移的一种特例,其中用于减法和除法的常数被特别选为该数据集的最小值和极差。
我们为何要关注特征缩放与归一化?首要原因是为了实现更快的收敛。
最小-最大归一化与标准化等特征缩放技术被用于提升梯度下降等优化算法的收敛速度。
标准化是一种线性变换。它所做的仅仅是使均值为零、标准差为一。
将标准化定义为一种线性变换,这与‘它会把分布形状变为正态’这一误解形成鲜明对比。
更新规则直接引用了代价函数 J。
梯度下降的更新规则是通过对代价函数求偏导数而得到的。
讨论特征缩放对收敛速度的影响。
特征缩放直接影响梯度下降更新规则所采取的步长大小。
讨论特征缩放对距离计算的影响。
通过 KNN/K 均值算法示例,说明了距离计算中特征缩放的基本原理。
项目符号文字明确指出“恰当计算距离”。
直角三角形图示直观地将坐标差与两点间的距离联系起来。
幻灯片关于‘恰当计算距离’的论断,通过将点与点之间的分离在几何上分解为水平分量和垂直分量来加以说明。
主讲人定义了特征缩放并展示了一个示例。
屏幕上显示了最小-最大标准化的公式。
最小-最大归一化:x′ = (ₘᵢₙ) ∕ (xₘₐₓ − xₘᵢₙ)
标准化:x′ = (̄) ∕ σ
如果我们进行标准化,就会使分布变成正态分布——这种说法完全错误。
我们为何要关注特征缩放与归一化?首要原因是为了实现更快的收敛。
θᵢ 更新为 θᵢ 减去 α 乘以 对 θᵢ 的偏导数
因各方向步长差异而导致振荡现象的解释。
水平方向分量主导距离的原理说明。
散点图在归一化前后的可视化变换。
标题与要点条目直接陈述了主题及原因。
黄色、蓝色和紫色线段在两个高亮显示的点之间构成一个直角三角形。
已覆盖 · 开场介绍与频道更新;无数学内容。
已覆盖 · 原始连续特征 x 及其直方图介绍。
已覆盖 · 基础特征缩放的讲解与可视化。
已覆盖 · 缩放与平移的讲解与可视化。
已覆盖 · 最小-最大归一化的讲解与可视化。
已覆盖 · 最小-最大归一化的介绍与公式,并配以可视化演示。
已覆盖 · 标准化的介绍与公式,并通过可视化示例澄清关于正态分布的常见误解。
已覆盖 · 解释特征缩放为何重要,重点说明其如何加快梯度下降的收敛速度,并展示相关公式。
已覆盖 · 涵盖特征缩放对梯度下降中更快收敛的重要性介绍,包括相关公式及可视化演示。
已覆盖 · 涵盖特征缩放的第二个原因:确保基于内存的算法中距离计算的合理性,并通过散点图与归一化动画加以演示。
已覆盖 · 数学总结幻灯片,画外音结尾语在此幻灯片上开始播放。
已覆盖 · 宣传性结束卡片,仅配器乐音乐;无进一步数学内容。
已审核中文素材 v1:知识卡片(概念卡片)「最小-最大归一化」从 1:29 起——最小-最大归一化是一种特定类型的缩放与平移,用于将数据标准化到一个固定区间,通常是[0, 1]。其计算方式为:先减去该特征的最小值(),再除以该特征的取值范围()。视频中显示,该方法使直方图紧密收缩在零附近。 x' =
已审核中文素材 v1:知识点条目(formula)「最小二乘代价函数」出现在 3:27–3:36——最小二乘代价函数用于衡量预测值(基于模型参数与特征计算得出)与实际目标值之间的平均平方差,常用于线性回归。 用于回归问题,目标是预测一个连续值。; 假设特征与目标变量之间存在线性关系。
已审核中文素材 v1:knowledge_item「均方误差代价函数」出现在 3:36——该公式计算预测值()与实际目标值()在全部 个训练样本上的平均平方差,是梯度下降旨在最小化的目标函数。
已审核中文素材 v1:例题(例题)「使用未缩放特征的线性回归」出现在 3:36–4:11——分析当两个特征具有不同取值范围时,特征缩放对梯度下降收敛性的影响。 分析特征尺度差异对优化过程的影响。 应用的更新规则。; 应用的更新规则。; 由于乘以误差项,其数值较小时会导致的更新量较小。; 由于乘以误差项,其数值较大时会导致的更新量较大。
标准化(或 Z 分数归一化)是一种线性变换,将数据中心化为零并将其缩放为标准差为一。它从每个数据点中减去特征的均值,然后除以标准差。
适用条件:应用于连续数值特征。;需要知道特征的均值和标准差。;标准差不能为零(以避免除以零)。
最小二乘成本函数衡量预测值(基于模型参数和特征)与实际目标值之间的平均平方差。它通常在线性回归中用于评估模型性能。
适用条件:用于目标是预测连续值的回归问题。;假设特征和目标变量之间存在线性关系。
当特征未缩放时,梯度下降会振荡,因为具有巨大不同范围的特征导致对其相应参数的梯度差异很大。这导致小尺度特征的参数步长很小,而大尺度特征的参数步长很大,从而导致向最小值的路径低效且呈锯齿状。
适用条件:用于带有梯度下降的线性回归优化。;特征具有显著不同的尺度(例如,一个范围从 0 到 1,另一个从 100 到 1000)。
特征缩放很重要,主要是为了在梯度下降等优化算法中实现更快的收敛,并确保基于距离的算法适当地计算距离,而不会让较大尺度的特征占主导地位。
适用条件:适用于梯度下降等迭代优化算法。;适用于 KNN 或 K-means 等基于距离的机器学习算法。
不,标准化不会改变其分布的一般形状;它只是将均值平移为零并将标准差缩放为一。它是一种线性变换,因此高度偏斜的分布在标准化后仍然保持偏斜。
适用条件:数据集具有明确定义的均值和标准差。;标准化作为线性变换应用。
在依赖距离度量的算法中,具有较大数值范围的特征会不成比例地影响总距离。具有较大尺度的特征将主导距离度量,无论其实际预测重要性如何,因为其坐标差异在数值上大得多。
适用条件:适用于 KNN 或 K-means 等基于距离的机器学习算法。;特征未缩放或未归一化。;使用标准度量(如欧氏距离)计算距离。
梯度下降是一种优化算法,通过沿成本函数对这些参数的梯度的相反方向迭代更新模型参数来最小化成本函数。
适用条件:成本函数 J 必须对参数 可微。;必须适当选择学习率 以确保收敛。
最小-最大归一化是一种线性变换,将原始特征值缩放到固定范围,通常为 [0, 1]。它从每个数据点中减去特征的最小值,然后除以范围(最大值减去最小值)。
适用条件:应用于连续数值特征。;需要知道特征的最小值和最大值。;最大值和最小值不能相等(以避免除以零)。