线性回归即直线拟合
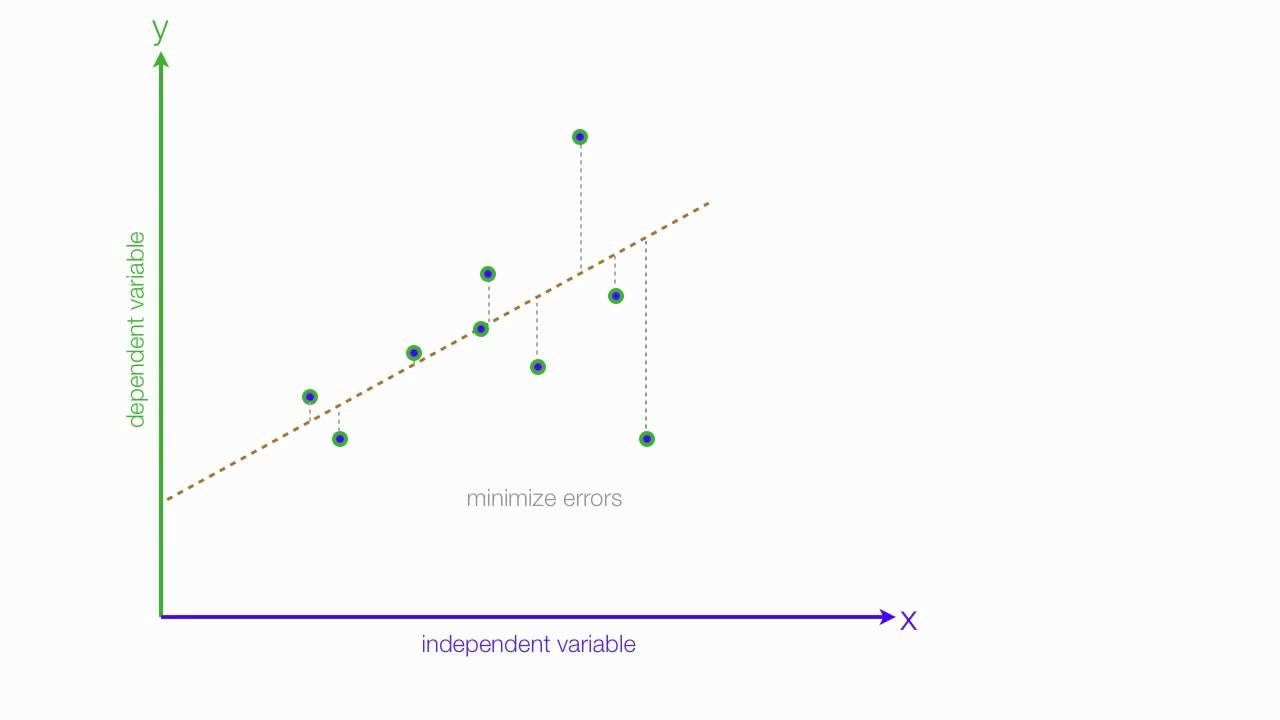
线性回归是一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。直观解释将其简化为:在散点数据中拟合一条直线,从而对未知数据做出预测,前提是假设变量间存在线性关系。
3-Minute Data Science · YouTube · 3:54
本3分钟入门讲解视频将线性回归定义为:通过拟合一条直线(或超平面)来预测数据点。它引入模型(或),解释斜率与截距的作用,将该思想推广至多个输入变量,并通过残差、平方误差及 SSE 损失函数引出最小二乘准则。视频最后展示了用梯度下降法最小化 SSE,并描述了用于验证的训练、测试划分。 这段54秒长的片段是一则简短线性回归讲解视频的结尾部分。它首先展示一幅散点图,并叠加一条黄色回归直线,旁白指出其目的在于确保回归模型在未见过的数据上表现良好。随后切换至“性能指标”幻灯片,列出线性回归的四项评估概念:、估计标准误、预测区间和统计显著性,每项均配有简短的屏幕文字定义。其余部分为创作者图书与 O’Reilly 课程的推广式结束内容,最后以纯黑画面配音乐收尾。
在学习检查器中查看要点和时刻,或切换阅读标签查看完整笔记。
依据视频画面与讲解整理,并非逐字语音转写。
本片段以简短的动画标志和标题“3分钟掌握线性回归”开场。此时尚未呈现任何数学内容;该部分仅起品牌标识与主题引入作用。
首个数学场景展示一幅散点图:青色数据点分布在黑色坐标轴上。随后,一条黄色直线穿过这些点构成的点云。画外音在此图像上将线性回归定义为一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。画面将该定义简化为人们熟知的任务——通过数据拟合一条直线,从而在关系近似呈线性时,对未见过的输入作出预测。
画面转为方程。一个高亮框标记出,并标注为“输出”,与画外音中称为因变量的说法一致。接着,该方程被重写为,高亮框随之移至,标注为“输入”,由此确立为自变量。本段将符号表示与先前的散点图建立联系:这条直线不仅是一幅绘图,更是关于输入的函数之图像。
同一模型随后以统计符号形式重述为,再进一步写作。画外音解释道:对应斜率,对应截距(在机器学习中亦称偏置)。动画使这一区别具象化:当强调斜率项时,直线绕某点旋转;当强调截距项时,整条直线垂直平移。本段结尾指出,这两个系数正是线性回归所求解的量,并出现一个数值示例。
方程逐步展开,从单个输入扩展至多个输入:先是,再是,最后到。画外音说明,每个新增的β都作为其对应变量的斜率。随后画面跃升至三维空间:一张青色网格平面穿过一团散点。这直观地印证了如下论断——在更高维空间中,拟合对象是一个超平面,而非直线。
画面回到2维散点图,视频提出问题:如何选择最优直线?从每个数据点向黄色直线引出红色垂直线段。这些线段被标识为残差:即观测值与当前直线所作预测之间的差异。下一步是对每个残差取平方,动画则将每条红线变为一个红色正方形。这种视觉编码揭示了为何要取平方:较大的残差会生成不成比例地更大的面积。
所有红色正方形随后合并为一个更大的红色块体,并标注为“SSE”。画外音解释道:将所有平方误差的面积相加,得到平方误差和(SSE),这正是该拟合问题的损失函数。此处提出的关键命题是:所期望的系数和,正是使SSE最小化的那组值。于是,几何问题“哪条直线拟合得最好?”便转化为一个优化问题。
本片段现在展示实现该优化的一种方法。屏幕一分为二:左侧为2维散点图,其中候选直线持续更新,同时和的数值随之变动;右侧为一个3维碗状曲面,代表损失函数在参数空间上的形态,一条红色路径沿曲面下降,趋近最低点。画外音将此方法命名为梯度下降,并提及矩阵分解是另一种可能的技术,但仅对梯度下降进行了可视化。其核心关联在于:在损失曲面上向下移动,对应于调整直线,从而使SSE减小。
最后一段由拟合转向验证。一幅更密集的散点图被重新着色为两个子集:标为TEST的红色点与标为TRAIN的青色点。括号标出两者的比例:TEST占,TRAIN占。画外音解释该工作流程:先用训练集拟合回归直线,再用预留的测试集验证模型性能。本片段由此收尾,将前文所述的最小二乘拟合过程,与标准的机器学习评估实践联系起来。
该片段以一幅散点图开场:红色数据点呈散布状,上方叠有一条斜向上延伸的黄色直线。画外音随即说明,正在讨论的这一过程旨在确保回归模型在未见过的数据上表现良好。由于本片段从中段开始讲解,此前的具体步骤并未呈现,但画面清晰地将该陈述与散点数据上拟合出的线性模型关联起来。
屏幕切换为一张黑色幻灯片,标题为“性能指标”。当旁白逐条列出用于评估线性回归的指标时,依次出现四个项目符号。第一项是,屏幕上描述为:衡量变量间变异可预测性,范围介于0与1之间。第二项是估计标准误,描述为:衡量线性回归的整体误差。第三项是预测区间,描述为:以统计区间而非单一数值的方式进行预测。第四项是统计显著性,描述为:利用p值来判断线性关系纯属偶然的概率。
数学内容到此结束。视频其余部分为结束语:一张“感谢观看!请予支持”幻灯片,包含两本O’Reilly图书封面;随后短暂切至O’Reilly课程网页;并配有旁白,推广作者的图书与课程。从49秒起,屏幕全黑,仅播放背景音乐。
线性回归是一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。直观解释将其简化为:在散点数据中拟合一条直线,从而对未知数据做出预测,前提是假设变量间存在线性关系。
输出变量记为,称为因变量;输入变量记为,称为自变量。同一关系也可用函数记号写作,强调输出是输入的函数。
在一元模型中,或控制直线的斜率,而或控制截距。截距在机器学习中也被称为偏置(bias)。动画通过斜率变化时旋转直线、截距变化时垂直平移直线,来区分这两种作用。
该模型可扩展至多个输入,每个输入对应一个系数。在更高维空间中,拟合对象不再是直线,而是一个超平面;动画中以一个穿过3D点云的平面加以示意。
残差是观测数据点与当前拟合直线所预测值之间的垂直距离。在动画中,它们表现为连接各数据点与黄色直线的红色线段。
每个残差被平方后形成平方误差。视频中通过将每条红色线段变为一个红色正方形来表示这一过程,使损失贡献以面积形式直观可见。因此,较大的残差会产生不成比例地更大的影响,因为正方形面积的增长速度超过残差长度本身。
将所有平方误差相加,得到平方误差和,记为 SSE。这一总体度量被称为损失函数,拟合目标是选择和,使得 SSE 最小化。
该片段将梯度下降可视化为一种最小化损失的方法:一个3D 碗状曲面表示损失关于参数的变化情况,一条红色路径则向最低点下降;与此同时,2D 拟合直线及显示的值同步更新,从而将参数空间中的下降过程与回归直线的变化联系起来。
为验证所拟合的模型,需将数据集划分为训练集和测试集。本视频采用常见比例:训练集占,测试集占;训练数据用于拟合回归直线,测试数据用于评估该直线。
开场旁白指出,本步骤的目的是确保回归模型在未曾见过的数据上仍能表现良好。同步显示的视觉画面是一张散点图,红色数据点上方有一条黄色拟合直线,体现线性回归情境。该片段未展示训练集/测试集划分,也未呈现任何明确的验证示意图,因此这只是对目的的口头陈述,而非实际演示的操作流程。
一张标题为“性能指标”的幻灯片,介绍了四种评估线性回归的方法:、估计标准误、预测区间和统计显著性。旁白明确指出这些是用于评估线性回归的指标,幻灯片则逐一呈现这四项内容。
幻灯片将定义为:“衡量变量间变异可预测性,范围介于0与1之间。” 在本片段中,它仅作为线性回归性能的汇总指标呈现,并注明其取值范围为0至1。此处未给出任何形式化的推导过程,也未说明标准的已解释方差公式。
该指标在屏幕上定义为:衡量线性回归的整体误差。它作为性能指标列表中的一项被引入,但本片段中未提供其公式、计算方法或具体示例。
幻灯片将预测区间描述为:以统计区间而非单一数值的方式进行预测。这区分了区间预测与点预测,但本片段并未解释该区间如何计算,也未说明所采用的置信水平。
最后一个指标被描述为使用 p 值来判断线性关系纯属偶然的概率。这仅是一个简要的概念性介绍;该片段未说明零假设、检验统计量或决策规则。
按知识点查看条件、步骤和证据。补充解释与视频直接内容分别标明。
屏幕上显示方程。
讲解员指出,是输出变量,也称为因变量。
一个黄色框高亮显示,其下方出现标签“输出”。
y
输出变量;因变量。
线性模型中的实值输出变量。
屏幕上显示方程。
讲解员指出,作为输入变量,也称为自变量。
一个黄色框高亮显示,其下方出现标签“输入”。
x
输入变量;自变量。
线性模型中的实值输入变量。
显示的方程由变为。
讲解员指出,输出也可表示为,即输入变量的函数。
输出变量的函数记号。
输入变量的实值函数。
系数出现在中,随后又出现在中。
讲述者指出,系数和通常被理解为和,而或控制直线的斜率。
当强调斜率项时,直线围绕其截距点旋转,而散点位置保持不变。
m
拟合直线的斜率系数。
线性模型中乘以输入变量的实值系数。
系数出现在中,随后又出现在中。
讲述者指出,或控制直线的截距,在机器学习中也称为偏置(bias)。
当强调截距项时,直线在不改变斜率的前提下作垂直平移。
b
拟合直线的截距系数;在机器学习中也称为偏置(bias)。
线性模型中的实值加性常数。
方程显示在屏幕上。
讲解员指出,和分别可能表示为和。
随后,在中以红色高亮显示。
斜率系数的另一种记法。
乘以输入变量的实数值系数。
方程显示在屏幕上。
讲解员指出,或控制截距,也称为偏置项。
随后,在中以红色高亮显示。
截距系数的另一种记法;也称为偏置项。
线性模型中的实数值加性常数。
方程依次演进为、、、。
讲解员指出,该模型可推广至多个输入变量,以及等。
, , , ,
扩展线性模型中的多个输入变量。
实数值预测变量。
随着方程扩展为多个输入,额外的系数随之出现。
讲解者指出,这些系数分别充当各个变量对应的斜率。
, , ,
与额外输入变量相关联的斜率系数。
乘以对应输入变量的实数值系数。
残差平方被直观求和后,一个标有“SSE”的红色方块出现。
讲解者指出,将所有正方形的面积相加,得到平方误差之和,即损失函数。
SSE
平方误差之和;用于拟合直线的损失函数。
非负标量,表示残差平方的聚合值。
左侧面板显示不断变化的数值,例如、,随后是、,再之后是、。
所显示的直线与3D曲面标记随数值更新而同步变化。
中间数值的精确变化序列仅能逐帧部分辨识。
m, b
优化过程中当前的候选斜率与截距值。
正在调整的实数值参数。
屏幕上的指标名称显示为。
讲解者在用于评估线性回归的指标中提到了“R方”。
此处使用的决定系数是线性回归的一种性能指标;幻灯片将其描述为衡量变量间变异可预测性的得分,范围介于0与1之间。
屏幕上描述的指标值范围为0到1。
讲解者将线性回归定义为一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。
一幅青色点构成的散点图出现,随后一条黄色直线穿过这些点。
讲解者用通俗语言解释:可以将其理解为通过数据点拟合一条直线,从而在假设变量间存在线性关系的前提下,对未知数据做出预测。
线性回归被呈现为一种统计方法,用于建模输出变量与一个或多个输入变量之间的关系。视觉化解释将其简化为:在散点数据中拟合一条直线,以便在假设变量间存在线性关系的前提下,对未见过的输入进行预测。
假设变量之间存在线性关系。
用于对未知数据进行预测。
屏幕显示,然后显示。
讲解者指出为输出变量(即因变量),为输入变量(即自变量)。
黄色方框突出显示标为“输出”的和标为“输入”的。
该模型用表示输出变量,也称为因变量;用表示输入变量,也称为自变量。同一关系也可用函数记号写作。
适用于图中所示的单输入线性模型。
方程依次变为,随后变为。
讲解者指出,或控制斜率,而或控制截距,截距在机器学习中也称为偏置(bias)。
改变斜率项会使直线绕原点旋转;改变截距项会使直线沿垂直方向平移。
在图示的线性模型中,(或)是斜率系数,(或)是截距系数。动画区分了二者的作用:斜率改变直线的倾斜程度,截距改变其垂直位置。讲解者还指出,线性回归求解的正是这两个系数。
适用于图中所示的单变量线性模型。
视频指出,线性回归求解的就是这些系数。
该方程逐步展开为,再进一步扩展为更多项,直至。
讲解者指出,该模型可扩展至多个输入变量,每个变量对应一个贝塔系数,这些系数起到斜率的作用。
画面切换至一个3维坐标系,其中分布着散点及一个青色网格平面。
讲解者指出,在更高维度中,线性回归被可视化为一个超平面。
视频将单输入变量的直线模型推广至多个输入变量,每个输入变量拥有各自的系数。在更高维度中,拟合对象不再是直线,而是一个超平面,图示为穿过一个3维点云的平面。
适用于存在多个输入变量的情形。
视频以超平面的形式直观呈现高维情形。
讲解者提问如何拟合这条直线,并指出各数据点与该直线之间的差异。
每条青色数据点与黄色直线之间均出现红色垂直线段。
讲解者称这些红色线段为残差,并指出它们代表数据点与该直线所作预测值之间的差异。
残差定义为观测数据点与拟合直线所预测值之间的差异;在图示中,它们表现为连接各数据点与黄色回归直线的红色垂直线段。
相对于选定的拟合直线来定义。
在该一维散点图示例中展示。
讲解者指出,要将每个残差分别平方。
每条红色残差线段变为一个以数据点和拟合直线为锚点的红色正方形。
讲解者将这些称为平方误差,并指出较大的残差会产生面积更大的正方形。
每个残差经平方后形成一个平方误差。动画通过将每条垂直残差线段转变为红色正方形来表示这一过程,使误差的大小以面积形式直观呈现。较大的残差所产生的正方形面积会不成比例地更大。
直接由残差推导而来。
在求和形成损失函数之前使用。
讲解者指出,将所有正方形的面积加总,就得到平方误差之和,即损失函数。
各个红色小正方形合并成一个标有“SSE”的较大红色正方形。
视频中介绍的损失函数是平方误差之和,简称为SSE。它通过对给定直线的所有平方残差面积求和得到。
针对某条候选直线定义。
用作待最小化的量。
讲解者指出,系数可通过从矩阵分解到梯度下降等多种技术求解。
分屏画面左侧显示一个2D散点图并带有一条移动的直线,右侧显示一个3D碗状曲面,并有一条红色路径向最低点下降。
当直线变化时,和的数值随之更新。
视频提到了矩阵分解,但未展示其公式或步骤。
视频将梯度下降呈现为一种寻找使SSE最小化的系数的方法。右侧面板可视化参数空间上的损失曲面,左侧面板则在搜索趋近最小值的过程中,同步更新拟合直线以及显示的和数值。
用于最小化损失函数。
视频明确描绘了梯度下降过程;矩阵分解仅被提及。
讲解者指出,实践者通常取三分之一的数据作为测试数据集,剩余三分之二则构成训练数据集。
一个密集的散点图被分为红色的测试点和青色的训练点。
方括号标注了比例:代表测试集,代表训练集。
讲解者指出,训练集用于拟合回归直线,测试集用于验证该直线。
为验证线性回归,视频描述了将数据划分为训练集和测试集的方法:训练集占全部点的三分之二,用于拟合回归直线;测试集占三分之一,专用于验证。
这是一种常见做法,并非唯一可能的划分方式。
训练数据用于拟合模型;测试数据用于验证模型。
讲解者说:“这样做的目的是确保回归模型在未曾见过的数据上也能表现良好。”
此句讲述时,画面显示一幅散点图:红色数据点,以及一条黄色的向上倾斜直线。
该片段从思考中途开始,因此“这样做的”所指代的确切先前操作并未出现在所提供片段中。
视频指出,评估步骤旨在检验回归模型在未曾见过的数据上是否表现良好;画面上同步呈现的是一条穿过散点观测值的拟合直线,将口语中提到的回归性能与数据上的线性拟合直观关联起来。
适用于本视频所示情境下的回归评估。
由于片段从中段开始讲解,所指的具体操作流程并未完整呈现。
讲解者说:“用于评估线性回归的指标包括R方、估计标准误、预测区间,以及统计显著性。”
幻灯片标题为“性能指标”。
依次出现四个项目符号:、估计标准误、预测区间和统计显著性。
本片段介绍了用于评估线性回归的四个命名指标:、估计标准误、预测区间和统计显著性。幻灯片在标题“性能指标”下列出它们,旁白明确将其表述为评估线性回归所用的工具。
这些被呈现为线性回归的评估指标。
本视频片段未推导这些指标的公式。
屏幕文字显示:“——衡量变量间变异可预测性的得分,取值范围为0至1。”
旁白将“R方”列入用于评估线性回归的指标列表中。
“变异可预测性”这一措辞较为非常规,可能反映了原始幻灯片中表述不够严谨;本片段未对其作更严格的定义。
幻灯片将定义为一种描述变量间变异可预测性的得分,其取值范围为0至1。在本片段中,仅被列为线性回归若干性能指标之一,未给出正式推导或更深入的技术解释。
屏幕上描述其取值范围为0至1。
此处专门用作评估线性回归的度量标准。
讲解者说:“我们需要找到使平方误差和最小的 β₀ 和 β₁ 系数。”
在该陈述说出的同时,红色的 SSE 区块始终保留在画面上。
系数和应被选取以最小化平方误差和。
正在拟合一个如图所示形式的线性模型。
损失函数是平方误差之和。
针对图示的线性回归设定,请选择使 SSE 最小的系数。
讲解者指出,在这些更高维度中,线性回归可被可视化为一个超平面。
一个3维点云被一个青色网格平面所截取。
在更高维度中,线性回归被可视化为一个超平面。
该模型已被扩展至多个输入变量。
针对视频中展示的多变量扩展情形。
红色垂直残差线段首先出现,随后变为红色正方形,最后合并为一个标有 SSE 的单个红色正方形。
讲解者解释了残差、对残差进行平方、累加各面积,并将该结果识别为损失函数。
从一条拟合直线和一组数据点开始。
这是在引入残差之前立即展示的设定。
测量每个数据点与直线之间的垂直距离;这些就是残差。
讲解者将残差定义为数据点与该直线所给出的预测值之间的差异。
对每个残差进行平方,得到平方误差。
讲解者明确指出要对每个残差进行平方,动画则将每条线段变为一个正方形。
将所有数据点对应的平方误差相加,得到平方误差和。
讲解者指出,将所有正方形的面积加总即得平方误差和,画面中这些正方形合并为一个标有“SSE”的色块。
将SSE识别为需通过选择和来最小化的损失函数。
讲解者称SSE为损失函数,随后指出系数必须使其最小化。
视频中展示的拟合目标是:选择直线的系数,使得残差平方和(SSE)最小。
左侧面板实时更新直线及显示的值,右侧面板则呈现一条红色轨迹,在碗状的3D曲面上向下移动。
讲解者说明图中描绘的是梯度下降法,并指出可采用包括梯度下降在内的多种技术求解系数。
梯度下降的精确数学更新规则未予展示。
将损失表示为关于系数参数的曲面。
右侧面板显示一个对应拟合损失的3D碗状曲面。
沿曲面朝损失值更低的方向移动。
一条红色路径沿曲面下降,趋近其最小值点。
当该路径移动时,左侧面板中对应的斜率与截距值同步更新。
屏幕上显示的数值和随移动的直线一同变化。
该过程收敛于使残差平方和(SSE)减小的参数值。
讲解者将这一图示与求解使平方误差和最小化的系数联系起来。
该动画将梯度下降阐释为:在系数空间中进行迭代搜索,不断降低损失,直至逼近最小值。
显示一幅由青色点构成的散点图,并配有一条黄色拟合直线。
该模型首先写作,然后是,接着是,最后是。
讲解者说明如何用一条直线拟合数据点,并指出斜率与截距各自所起的作用。
图中所绘各点的底层数值坐标并未给出。
通过一组离散的数据点拟合一条直线,并解释模型参数的含义。
展示了一组数据点的散点图。
模型形式为,或等价地写作。
理解该直线如何刻画数据,以及各系数所代表的意义。
介绍仅含一个输入变量的线性模型。
这是散点图之后首次显示的方程。
使用函数记号重写输出表达式。
讲解者指出,输出也可表示为。
将和替换为统计学符号。
讲解者指出,系数通常被理解为和。
展示一个具体系数已拟合的实例。
最终显示的方程将系数替换为具体数值。
该实例演示了一个单变量模型中斜率为、截距为的拟合直线。
视频通过斜率变化时旋转直线、截距变化时垂直平移直线的方式,直观验证了这种解释。
方程从单个输入扩展至多个输入,最终以结尾。
画面切换为一个带有青色平面的3维点云。
讲解者说明该模型可推广至多个输入变量,并指出在更高维度中,它被可视化为一个超平面。
将单输入线性模型推广至多个输入变量,并在更高维度中可视化其结果。
单变量模型已确立。
展示新增输入如何添加新的斜率项,以及几何形态如何变化。
添加第二个输入变量,并为其分配独立的系数。
这是在单变量情形之后首次展示的扩展方程。
逐个继续添加更多输入变量。
方程在屏幕上逐步扩展。
展示本片段中使用的广义多变量形式。
这是在3D可视化之前展示的最终扩展方程。
将高维拟合解释为穿过数据点的超平面。
讲解员明确说出这一点,动画则展示一个平面穿过3D点云。
多变量模型为每个输入分别添加一个 beta 系数,而拟合对象在更高维度中成为一个超平面。
验证方式是视觉化的:原先的2D直线示例被替换为一个穿过散点的3D平面。
一幅密集的散点图被重新着色,其中红色代表 TEST 点,青色代表 TRAIN 点。
方括号标注的比例分别为和。
讲解者指出,三分之一的数据划入测试数据集,剩余的三分之二构成训练数据集,并进一步说明二者各自的作用。
演示如何划分数据,以验证已拟合的回归模型。
现有一个由散点组成的完整数据集。
将数据划分为训练部分与测试部分,并明确各自用途。
预留三分之一的数据作为测试集。
讲解者陈述该比例,动画相应地将红色子集标注为测试集。
将剩余的三分之二数据用作训练集。
讲解者说明这一点,青色子集被标注为TRAIN。
利用训练集拟合回归直线。
讲解者明确指出,训练数据集将用于拟合回归直线。
使用测试集验证拟合模型。
讲述者明确指出,将使用测试数据集来验证回归模型。
该示例将的数据分配给训练集(TRAIN)用于拟合,将的数据分配给测试集(TEST)用于验证。
验证过程兼具程序性与可视化:图表被划分为若干带标签的子集,各子集以不同颜色和比例呈现。
青色点出现在黑色坐标轴上,随后绘制一条黄色直线穿过这些点。
在该区间的末尾附近出现文字:“正态分布与直线吻合!”
视频片段中并未从数学角度深入阐释正态分布字幕的含义。
青色数据点
白色坐标轴
黄色回归直线
字幕文字
数据点首先出现。
随后,一条黄色直线穿过这些点构成的散点云。
一段关于正态分布的字幕短暂出现。
坐标轴保持固定。
数据点一旦绘出,便保持位置不变。
动画将线性回归介绍为:用一条直线拟合观测到的数据点。
一个黄色框高亮显示,并标注“输出”;接着方程变为,一个黄色框高亮显示,并标注“输入”。
方程文字
黄色高亮框
标注“输出”和“输入”
随着讲解逐一定义每个角色,高亮符号从移动到。
方程其余部分保持可见,同时逐项高亮显示。
可视化映射将代数符号与其在统计学中的角色(因变量与自变量)关联起来。
散点图重新出现,其下方显示方程;先高亮斜率项,直线绕其截距点旋转;再高亮截距项,直线垂直平移。
方程从变为,再变为具体数值系数。
散点图
黄色直线
高亮显示的系数项
当强调斜率项时,直线绕其截距点旋转。
当强调截距项时,直线上下平移而不改变倾斜程度。
数据点保持固定不动。
方程结构保持不变,仅对各项进行高亮显示。
动画分离了线性模型中两个系数各自的几何效应。
一个3D坐标系出现,其中分布着散乱的白色点,以及一个穿过这些点的青色网格平面。
3D坐标轴
白色点云
青色网格平面
场景从2D直线拟合切换为3D平面拟合显示。
这些点分布在平面周围,而非恰好落在平面上。
该平面代表拟合直线在更高维空间中的类比,即超平面。
红色垂直线段连接各点与黄色直线,随后每条线段变为一个红色正方形。
青色点
黄色直线
红色残差线段
红色正方形
垂直残差首先出现。
每个残差被转化为一个正方形,其边长等于该残差的大小。
原始数据点和拟合直线在变换过程中保持位置不变。
该可视化将平方误差编码为面积,使较大的残差对应较大的正方形。
各个独立的红色方块合并为一个较大的红色方块,标为 SSE。
各个独立的红色正方形
标为 SSE 的大红色方块
多个正方形合并为一个单一的聚合块。
标签 SSE 表示总和量。
合并后的区块表示对所有平方误差求和所得的总损失。
左侧面板:一个2D 散点图,含一条移动的直线和不断变化的值;右侧面板:一个3D 碗状曲面,其上有一条红色路径向最低点下降。
3D 曲面上的精确坐标标签无法辨认。
2D 散点图
移动的拟合直线
数值型斜率 m 和截距 b 的实时读数
3D 损失曲面
红色下降路径
左侧面板中的直线会随着右侧面板中红色路径的移动而实时更新。
在下降过程中,数值型系数的取值随之变化。
左侧面板中的数据点保持固定。
损失曲面的整体碗状形状保持不变。
分屏视图将参数空间中沿损失曲面的下降过程,与拟合直线的相应变化关联起来。
密集散点图被重新着色为红色 TEST 子集和青色 TRAIN 子集,并用方括号标注和。
密集散点图
红色 TEST 子集
青色 TRAIN 子集
分数标签
各点通过颜色变化表明其属于 TEST 还是 TRAIN。
方括号标签量化了这两个部分。
原始点的空间分布在重新着色后保持不变。
动画展示了数据集如何被划分为模型拟合与验证两部分。
一幅黑底坐标图显示大量红色圆形数据点,以及一条从左下方向右上方倾斜的黄色直线。
在讲述“回归模型在未见数据上表现良好”这句话期间,该图保持静止。
笛卡尔坐标轴
红色数据点
黄色回归线
在此时间段内,所绘制的点或线均无可见变化。
数据点保持固定。
黄色直线始终保持为一条穿过点云的单一、向上倾斜的线性拟合。
该画面通过展示对离散观测值的线性拟合,直观支持了关于回归性能的口头讲解。本片段未标注坐标轴,也未提供任何数值,因此解读属于定性而非定量。
标题“性能指标”首先出现。
项目符号逐条依次出现:,然后是“估计标准误”,接着是“预测区间”,最后是“统计显著性”。
标题文字“性能指标”
四个项目符号条目
幻灯片逐步构建,各项指标按顺序逐一出现。
背景保持黑色。
列表结构保持为度量定义的垂直序列。
动画将本课组织成一份简洁的线性回归评估概念目录,与讲解者口头列举的内容一致。
一张标题为“感谢观看!请给予支持”的幻灯片出现,展示两本O’Reilly图书封面及支持提示。
一个标题为“即将上线的实时在线培训课程”的浏览器页面在32–36秒左右短暂出现,所列课程包括:面向数据的SQL基础、6周掌握数据科学核心数学(含交互式内容)、从零开始学概率(含交互式内容)、SQL编程、从零开始学机器学习、以及面向人工智能的梯度下降与优化算法。
视频从课程网页返回至致谢幻灯片。
致谢幻灯片
图书封面:《数据科学核心数学》
图书封面:《SQL入门》
O’Reilly课程网页
画面从度量指标幻灯片切换至致谢幻灯片。
网页覆盖层短暂出现后随即消失。
最终的致谢幻灯片一直保留到临近结尾。
片尾内容以宣传性为主,而非数学性。
这些画面与叙述者关于书籍、现场教学及未来主题的结束语相对应。它们并未增添新的数学定义或推导过程。
讲解者说:“注意,残差越大,对应正方形的面积就被放大得越明显。”
较大的残差线段会变成肉眼可见更大的正方形。
人们可能认为所有残差对损失的贡献是均等的。
视频强调,平方运算使得较大的残差在损失中占据远为重要的地位,因为正方形的面积增长速度比残差本身的长度增长更快。
讲解者指出,在机器学习中,截距或也被称为偏置(bias)。
截距项可能被误认为仅是几何意义上的y轴交点,在机器学习中并无专门的模型名称。
视频明确指出,截距或在机器学习术语中即为偏置。
叙述者指出,其目的是确保回归模型在未曾见过的数据上表现良好。
可见图表仅展示一个散点图和一条拟合直线,未明确显示训练集/测试集划分。
观众可能误以为所展示的图表本身即体现了对未见数据的测试。
该片段仅通过口头陈述说明目的;画面为通用的回归散点图,并未展示独立的训练集、测试集或交叉验证流程。
幻灯片上写着:“衡量0与1之间变量的变异可预测性。”
短语‘变异可预测性’可能被误认为是一个正式定义。
本片段仅提供非正式描述。标准处理方式会通过已解释变异占总变异的比例来定义,但此处未给出该形式化定义。
幻灯片指出:统计显著性使用“p 值来判断线性关系纯属偶然的概率”。
措辞可能暗示 p 值直接给出了所观察到的线性关系纯属偶然的概率。
该片段未说明假设检验框架。在标准统计学中,p 值是在零假设下计算得出的,并非简单等同于该关系纯属偶然的概率。
在定义线性回归之后,讲解者引出了熟悉的线性函数。
画面从散点图的概念过渡到显式的方程表达。
线性回归的一般定义,通过显式方程及其函数记号来具体化。
同一方程被重写为含和的形式。
讲解者在引入记号后,解释和各自的含义。
变量命名完成后,模型内容即包含斜率系数与截距系数的具体作用。
单输入方程扩展为多个和项。
讲解者指出该模型可推广至多个输入变量。
多变量模型通过为每个额外输入变量增加一个系数,将单斜率、单截距的情形加以推广。
讲解者提问如何拟合这条直线,并立即指向数据点与直线之间的差异。
残差线段出现在已有的拟合直线图上。
解释如何拟合直线,需先定义数据与预测之间的偏差,即残差。
讲解者指出应对每个残差取平方。
每条残差线段变为一个正方形。
平方误差由残差直接得到,即对每个残差进行平方。
讲解者指出,将所有正方形的面积相加,就得到了平方误差和。
所有红色正方形合并为一个SSE方块。
损失函数SSE通过汇总所有平方误差而形成。
讲解者指出,在定义损失函数后,可使用包括梯度下降在内的多种技术求解系数。
3D损失曲面及下降路径出现。
梯度下降被呈现为一种用于最小化SSE损失函数的方法。
讲解者指出,为验证线性回归,实践者会将数据划分为训练集和测试集。
数据集被划分为TRAIN和TEST两个子集。
训练-测试划分是应用于前述线性回归模型的一种验证流程。
讲解者首先说明评估的重要性,随后立即列出用于评估线性回归的各类指标。
性能指标列表被呈现为实现前述评估目标的实际工具包。
作为‘性能指标’下的第一条项目出现。
概览项将列为所列评估指标之一。
估计标准误作为‘性能指标’下的第二条项目出现。
概览项将估计标准误列为所列评估指标之一。
预测区间作为‘性能指标’下的第三条项目出现。
概览项将预测区间列为所列评估指标之一。
开篇讲解定义了线性回归。
方程从变为。
讲解者将解释为斜率,将解释为截距(或偏置)。
该方程展开为多个项和项。
讲解者将残差定义为数据点与直线预测值之间的差异。
讲解者指出需对残差进行平方,并强调此举会放大较大误差的影响。
一个标有“SSE”的红色方块出现。
一条红色路径沿3D损失曲面下降,同时拟合直线不断更新。
标签分别显示:TEST对应,TRAIN对应。
讲解者指出,高维情形被可视化为一个超平面。
讲解明确说明了在未见过的数据上检验模型性能的目的。
讲解者逐一列举了用于评估线性回归的指标。
幻灯片以文字形式列出了相同的四个指标。
已覆盖 · 开场标志与标题序列,不含任何数学内容。
已覆盖 · 散点图与拟合直线引出线性回归——即通过直线拟合实现预测。
已覆盖 · 方程和分别定义输出变量与输入变量。
已覆盖 · 系数被重命名为,并演示了它们分别作为斜率与截距的作用。
已覆盖 · 模型扩展至多个输入,并在3D空间中被可视化为一个超平面。
已覆盖 · 红色垂直线段表示数据点与拟合直线之间的残差。
已覆盖 · 残差被平方后以红色正方形区域表示。
已覆盖 · 平方误差被汇总为 SSE,并被认定为损失函数。
已覆盖 · 分屏画面展示在损失曲面上通过梯度下降法搜索系数的过程。
已覆盖 · 数据集被划分为 TRAIN 和 TEST 两个子集,分别用于模型拟合与验证。
已覆盖 · 开场散点图及旁白,说明确保回归模型在未见过的数据上表现良好。
已覆盖 · 性能指标幻灯片,包含四个依次呈现的定义。
已覆盖 · 推广式结束页:致谢页、图书封面、简短的 O’Reilly 课程网页信息及结束语;不含新的数学内容。
已覆盖 · 纯黑画面,仅有背景音乐;不含数学内容。
已审核中文素材 v1:知识卡片(概念卡片)「线性回归即直线拟合」从 0:16 起——线性回归是一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。直观解释将其简化为:在散点数据中拟合一条直线,从而对未知数据做出预测,前提是假设变量间存在线性关系。 y = mx + b
已审核中文素材 v1:card「线性回归即直线拟合」出现在 0:16——线性回归是一种统计技术,用于建模输出变量与一个或多个输入变量之间的关系。直观解释将其简化为:在散点数据中拟合一条直线,从而对未知数据做出预测,前提是假设变量间存在线性关系。
已审核中文素材 v1:知识卡片(概念卡片)「残差」从 1:36 起——残差是观测数据点与当前拟合直线所预测值之间的垂直距离。在动画中,它们表现为连接各数据点与黄色直线的红色线段。
已审核中文素材 v1:card「利用梯度下降法搜索系数」出现在 2:24——该片段将梯度下降可视化为一种最小化损失的方法:一个3D 碗状曲面表示损失关于参数的变化情况,一条红色路径则向最低点下降;与此同时,2D 拟合直线及显示的值同步更新,从而将参数空间中的下降过程与回归直线的变化联系起来。